
Le climatologue Zeke Hausfather a consacré huit semaines à évaluer l’énergie nécessaire pour ses sessions avec Claude Code, découvrant une consommation d’environ 150 wattheures (Wh) par prompt, avec des mesures variant entre 60 et 290. Cela représente environ 600 fois1 200 fois170 kWh d’électricité en data centers, fluctuant entre 70 et 330 kWh selon les hypothèses prises en compte.
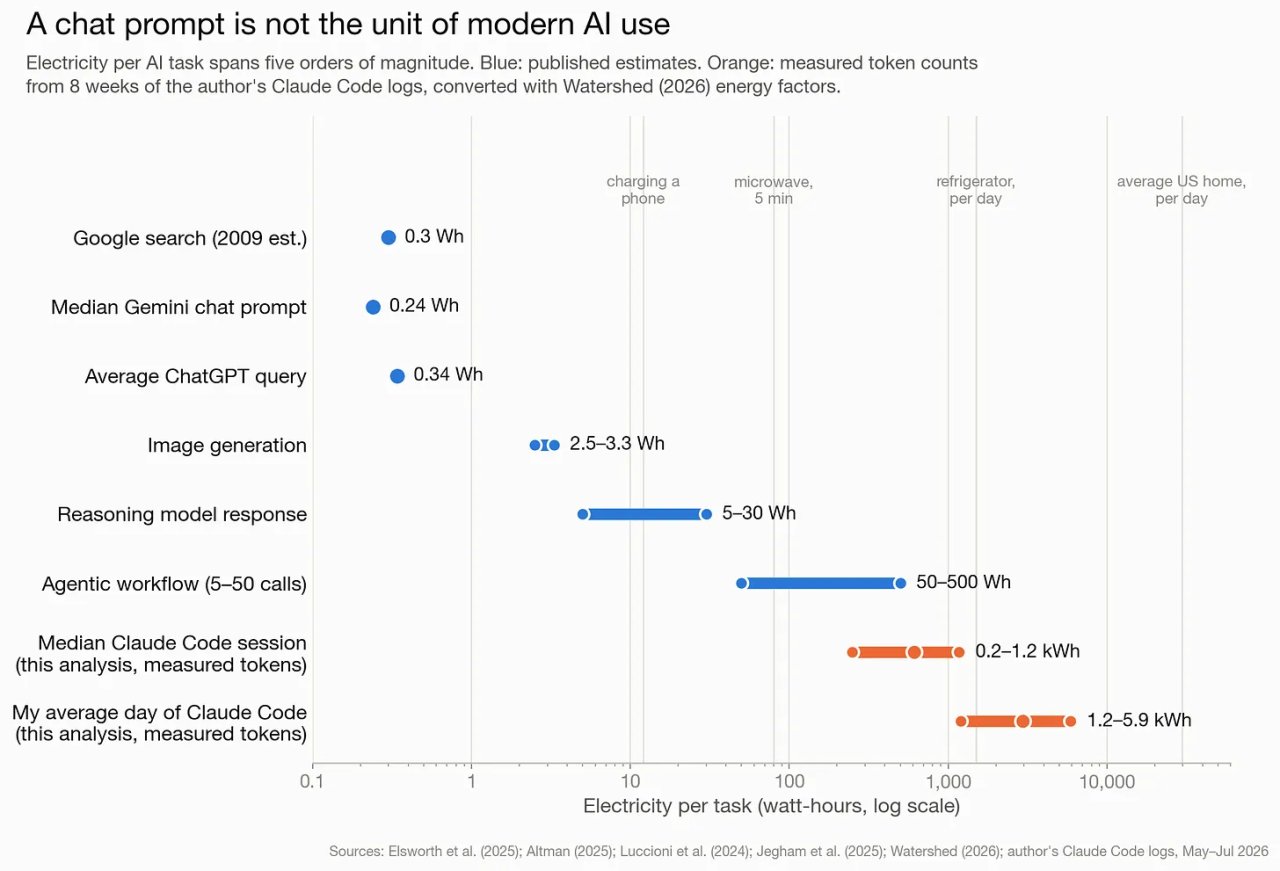
Pour sa part, Google estime qu’en 2025, un prompt moyen de Gemini utilisera 0,24 Wh, soit moins que neuf secondes passées devant un écran. Sam Altman a indiqué une consommation de 0,34 Wh pour une requête classique à ChatGPT, et Epoch AI arrive à des chiffres similaires. Un seul prompt représente environ un centcinquantième des émissions quotidiennes d’un Américain moyen, des chiffres que Hausfather considère essentiellement corrects. Néanmoins, ces chiffres parlent d’un usage de l’IA qui ne reflète pas réellement la pratique courante des développeurs ou chercheurs, où les agents effectuent des tâches comme coder, exécuter et analyser de manière autonome.
Claude Code stocke localement la transcription complète de chaque session, incluant les comptages de tokens retournés par l’API pour chaque appel. Au lieu de se baser sur des benchmarks disponibles, Hausfather s’est servi de ses propres données : la seule partie nécessitant des hypothèses est la conversion de tokens en énergie. Les 1 138 prompts utilisés ont généré un peu plus de 14 000 appels distincts au modèle, soit en moyenne douze par prompt, chaque prompt ayant consommé 2,9 millions de tokens. Un échange classique par chat via un navigateur en consomme environ mille.
Où vont les 3,2 milliards de tokens
Ce que l’utilisateur voit, c’est-à-dire la sortie du modèle, ne représente que 0,4% des tokens traités. Le 96% restante correspond aux lectures en mémoire cache : à chaque étape, lorsqu’un agent exécute une commande, lit un fichier ou appelle un outil, il retraite l’ensemble du contexte accumulé. La distinction est cruciale pour une estimation énergétique, car relire un token déjà en cache coûte beaucoup moins cher que d’en traiter un nouveau. Les entreprises du secteur facturent les lectures en cache environ 10% du tarif normal, une supposition que Hausfather utilise comme référence principale, considérant 1% et 25% comme extremes.
Aucun acteur extérieur ne connaît l’énergie réelle par token des modèles de pointe : Anthropic n’a pas publié de chiffres relatifs aux prompts ou aux tokens, et une étude de Watershed signale cette lacune comme l’un des plus grands manques de données du secteur. Hausfather a donc soumis ses évaluations à trois méthodologies indépendantes : les facteurs de secteur de Watershed (détaillés par la suite), ceux de Simon Couch basés sur les travaux d’Epoch AI, et les coefficients déduits des prix d’utilisation de l’outil CLAUDE-CARBON. Chacune a retourné des valeurs comprises entre 70 et 330 kWh pour les huit semaines, avec une incertitude d’environ un facteur deux dans les deux sens. Si l’on applique les mêmes 1 138 prompts aux tarifs publiés pour des chats, cela aurait produit 0,3 kWh.
Deux réfrigérateurs par jour
La session moyenne avec Claude Code consomme environ 0,6 kWh, soit cinquante fois l’énergie nécessaire pour charger un téléphone, au seuil supérieur de l’estimation générique donnée par Watershed pour l’utilisation par agents. La consommation journalière moyenne est de 3,0 kWh, oscillant entre 1,2 et 5,9. Cela correspond à ce que consomment deux réfrigérateurs11 kWh, avec plusieurs agents travaillant simultanément sur une analyse géospatiale complexe, équivalant à plus d’un tiers de la consommation électrique d’un foyer américain moyen. Dans la catégorie de l’usage par agents, la complexité de la tâche et le nombre d’agents actifs ont un impact significatif sur les résultats.
Les chiffres sont supérieurs à d’autres estimations sur l’utilisation par agents. Couch a calculé une session moyenne de Claude Code à 41 Wh, avec 24 appels au modèle et 592 000 tokens; le calculateur d’Andy Masley, publié en juin 2026, attribuant 459 Wh à une session de 100 000 tokens avec Claude Opus ; et Hannah Ritchie, supposant un utilisateur intensif avec 24 requêtes par jour, avait évalué une consommation de 2,4 kWh par jour. Toutefois, la session moyenne mesurée ici est de 600 Wh, avec plus de cent appels et une dizaine de millions de tokens, représentant ainsi une consommation journalière de 3,0 kWh contre 2,4 dans le scénario hypothétique. Ces estimations ne sont pas contradictoires, mais reposent sur des hypothèses d’utilisation différentes et semblent indiquer que les ingénieurs, chercheurs et analystes de données se situent plutôt en bas de la distribution.
En extrapolant ces huit semaines sur une année entière, on aboutit à environ 1,1 MWh d’électricité utilisée par les data centers, avec un éventail entre 0,4 et 2,2, soit un dixième de la consommation d’une famille américaine moyenne. En appliquant l’intensité moyenne du réseau américain, cela représente 370 kg de CO2 équivalent annuellement, variant entre 150 et 730. Au total, cela équivaut à 8% des émissions annuelles d’une voiture à essence classique et environ 2% des 18 tonnes du bilan d’un Américain moyen, ce qui est semblable à la consommation d’un sèche-linge électrique ou la moitié d’un vol retour en classe économique entre San Francisco et New York. Ce sont des sources d’émissions notables, mais qui, au même moment, demeurent modestes par rapport à d’autres, surtout dans un contexte où les objectifs de réduction sont de plus en plus difficiles à atteindre.
Ces observations trouvent écho dans une étude publiée par Watershed, qui a établi un cadre standardisé pour la comptabilité des émissions d’entreprise liées à l’IA. L’étude démontre que l’électricité utilisée par chaque tâche varie énormément, des milliwatts-heure pour une simple classification de texte, jusqu’à 50-500 Wh pour un flux agentique contenant entre 5 et 50 appels à un modèle de pointe ; les auteurs notent que les émissions attribuées à une seule interaction peuvent sous-estimer le calcul réel de plusieurs ordres de grandeur. Par ailleurs, d’autres chercheurs de Google et Microsoft ont observé que les agents de programmation consomment environ mille fois plus de tokens qu’un échange classique avec un chatbot. L’Index Économique d’Anthropic révèle que 97% de l’utilisation de ses API découle désormais de profils fortement automatisés, liés aux agents.
Pourquoi l’efficacité ne réduit pas les consommations totales
L’efficacité énergétique des puces de data centers de NVIDIA a augmenté d’environ 150 fois depuis 2016, doublant tous les deux ans selon Epoch AI. Les derniers modèles B300, en utilisant la précision minimale, nécessitent environ un quart de l’énergie des H100 de 2022 sur lesquels les modèles actuels ont été formés, représentant une amélioration de 3,8 fois en trois ans. Du côté du logiciel, Google a rapporté que l’énergie d’un prompt moyen de Gemini a chuté de 33 fois en une seule année. Néanmoins, si de tels gains réduisaient la consommation totale de l’IA, cela se verrait déjà. C’est ce qu’on appelle le paradoxe de Jevons : rendre le calcul moins coûteux par token engendre une augmentation de l’utilisation, et cette efficacité explique pourquoi ces huit semaines ont coûté 170 kWh au lieu des 950 qui auraient été nécessaires avec du matériel de 2020.
Sur un plan plus personnel, Hausfather évoque deux marges de manœuvre : la première consiste à ne pas être superflu avec les outils agentiques, car diriger cinq agents en parallèle sur un problème complexe n’est pas identique à le faire juste pour une mise au point. La seconde, c’est le choix du modèle : diriger les tâches simples vers des modèles plus petits pourrait consommer cinq à sept fois moins d’énergie par token que de se tourner par défaut vers un modèle de pointe. Toutefois, un impact annuel de quelques centaines de kilogrammes de CO2 sur la population des utilisateurs intensifs n’influe pas sur la courbe globale, et l’élément qui pèse le plus reste l’intensité carbone de l’électricité alimentant les data centers, toutes les évaluations prenant en compte la moyenne de l’ensemble du réseau américain.
Ce calcul a suscité des critiques : Boris Gamazaychikov, expert en durabilité des systèmes IA, a qualifié l’approche d’intéressante mais reposant sur des données obsolètes. Sa propre recherche sur la consommation énergétique des systèmes IA est attendue d’ici la fin septembre. En attendant, le tableau reste ce que Hausfather lui-même a décrit : des estimations basées sur des tarifs, des facteurs publiés et des transcriptions locales, en l’absence de données réelles par token fournies par les laboratoires capables d’évaluer la consommation réelle.
Points à retenir
- Hausfather a mesuré une consommation d’environ 150 Wh par prompt dans ses sessions avec Claude Code.
- Pour un usage classique, Google estime une consommation bien inférieure avec seulement 0,24 Wh par prompt.
- La majorité des tokens traités correspondent aux lectures en mémoire cache, ce qui influence significativement l’estimation énergétique.
- Les chiffres mesurés par Hausfather dépassent d’autres estimations antérieures, reflétant une utilisation plus intensive.
- Les améliorations en efficacité énergétique, bien que décennales, n’ont pas réduit la consommation totale due à l’augmentation de l’usage.
Réflexion personnelle : ces chiffres ouvrent la voie à un sujet important : quel équilibre devrions-nous adopter entre efficacité énergétique et usage responsable de l’IA ? En tant que passionné de technologie, je pense que la montée en flèche de l’IA pose des défis fascinants, tant pour les utilisateurs que pour les décideurs. La question n’est pas seulement comment économiser de l’énergie, mais aussi comment créer un cadre durable et éthique autour de ces outils puissants. Ce chemin nécessitera des efforts concertés et une réflexion profonde de notre part. La route est encore longue, mais elle en vaut la peine.